AI 音乐创作入门:歌词结构与风格描述怎么写
给 AI 音乐模型写歌词和风格描述有一套朴素的章法:结构标记、具象意象、少而准的风格词。
2026-08-12 · 约 3 分钟读完
作者:何屿(CPCX 撰稿人 · 图像与影音)
我写了同一段歌词,只改「主歌 / 预副歌 / 副歌」的标注,其余不动。标注清楚之后,生成结果的段落层次明显出来了——模型其实认这个结构,只是你不说它就自己乱分。
AI 音乐生成的两块输入
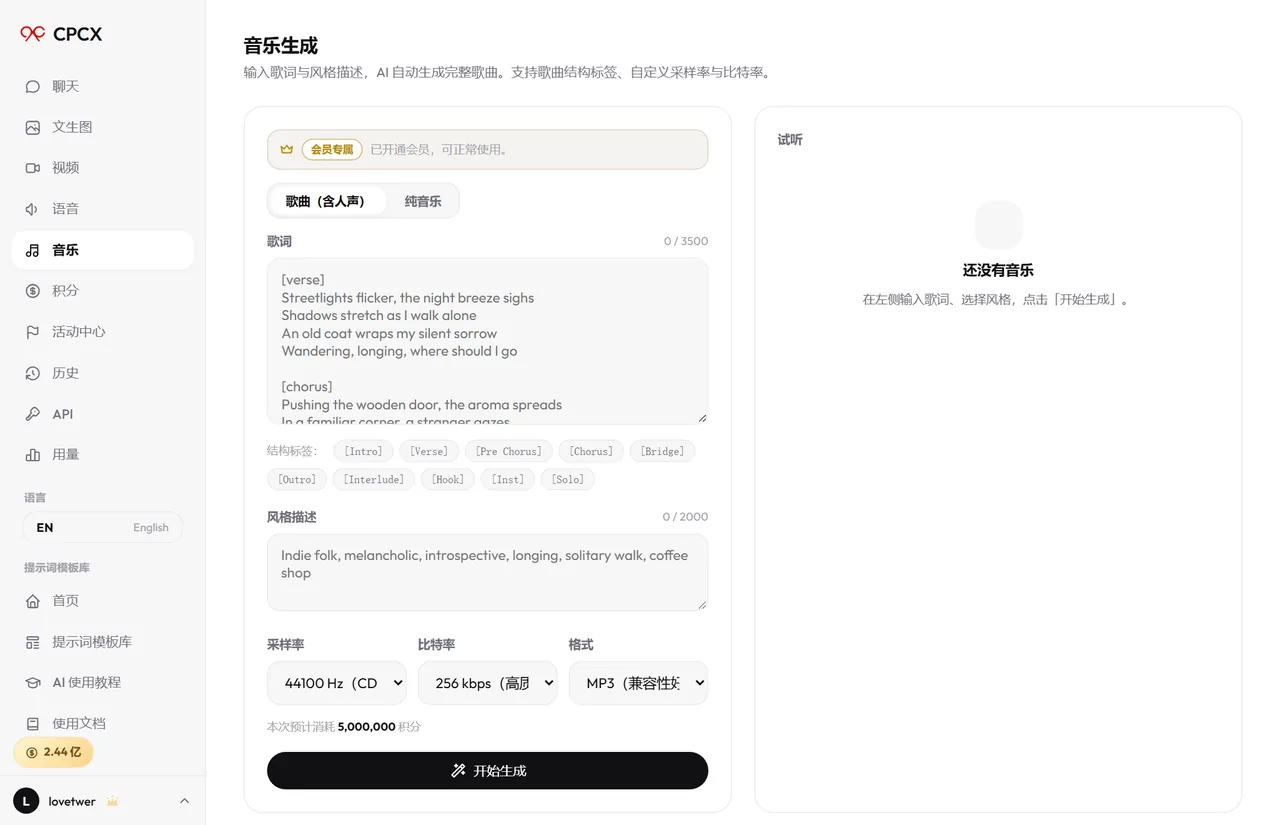
在我们的音乐生成工具里,决定成曲质量的是两块输入:歌词和风格描述。很多人把精力全花在风格词上,其实歌词的结构对成品的影响更大——模型是按你给的段落结构去编排主歌、副歌的。
歌词:给结构标记,写具象意象
写歌词时明确标注段落结构,例如「[Verse 1]」两段、「[Chorus]」副歌、「[Bridge]」桥段。有了标记,生成歌曲的起承转合立刻清晰。
意象要具体。「夏夜的风穿过便利店门口」比「我很难过」更有画面感,也更容易被谱上贴合的旋律。副歌部分写重复性强、情绪浓度高的短句,这是流行歌曲hook的基本规律,模型对这种规律响应很好。
先写副歌再写主歌是个好习惯。副歌定了,整首歌的情绪基准就定了。
风格描述:少而准,胜过多而杂
风格词三个左右就够了:「citypop,女声,日语」或者「民谣,木吉他,男声,慢速」。堆上十几个形容词(伤感 + 治愈 + 摇滚 + 轻快)只会让模型无所适从。
一个实用技巧:风格冲突时,把最想要的一个放最前面,权重最高的位置。想要「干净的编曲」,就把 clean arrangement 写在最前。
迭代:换变量而不是重写
第一次生成不满意时,别整段重写。先判断问题出在哪:旋律不对,调风格词;情绪不对,调歌词意象;结构乱,检查段落标记是否清晰。每次只动一个变量,你才能知道是哪个改动起了作用——这和调试代码是一个道理。
什么样的歌适合交给 AI 做
把需求分成两类会更清楚。适合的:短视频 BGM、口播背景乐、节日祝福歌、给自己小店写的宣传曲、做 demo 试听——这些场景要的是「有就行、能循环、不用为版权操心」,AI 音乐完全够用,而且改一版只要几十秒。
不太适合的:要正式发行的作品、需要真实人声情绪细节的歌、编曲层次复杂的成品(多层弦乐、和声堆叠)。目前 AI 最稳的产出是「结构清楚、情绪单一」的歌曲,要求越复杂,它越容易在副歌处塌掉。
- 先生成 30 秒试听,觉得方向对了再做完整版,比直接出整首歌省得多;
- 同一段歌词换三次风格描述,挑最顺耳的那版再往下迭代,别在第一版上死磕;
- 成品当素材而不是终稿用。叠一层环境音或一段真人哼唱,质感立刻不一样。
判断标准很简单:如果这首歌是要「给人听」还是「给画面配」,后者交给 AI 基本不会错。
这篇教程里的真实产出
站内生成的一段完整歌曲(歌词 + 四个风格词)
歌词按主歌副歌写好,风格只给了「城市流行,轻快,男声,吉他清晰」——具象的意象比堆风格词更管用。