AI 会一本正经地胡说八道:幻觉是什么,怎么防
AI 编造数据、虚构文献、张冠李戴不是故障而是机制。理解幻觉为什么发生,才能知道哪些场合必须人工核对。
2026-07-08 · 约 5 分钟读完
作者:陈叙(CPCX 内容负责人 · 提示词与方法)
我拿一个完全不存在的论文标题去问了五个模型,三个编出了完整的作者、期刊和卷期号,其中一个还给了 DOI。从那以后我把「要求标注不确定」当成必做步骤,而不是可选项。
幻觉不是 bug,是机制的副产品
语言模型的本质是预测「下一个最像样的词」。它没有「我不知道」的可靠开关——当它没学过某个细节,它依然会生成一段语法通顺、语气自信的文字来填充。于是出现了虚构的论文引用、不存在的法条、错误的历史日期,语气还特别笃定。
这不是偶尔抽风,任何 AI 对话工具都有这个特性,区别只在频率。理解了这一点,你就不会问「这个 AI 怎么会编」,而是会问「这个场景我能不能承受它编」。
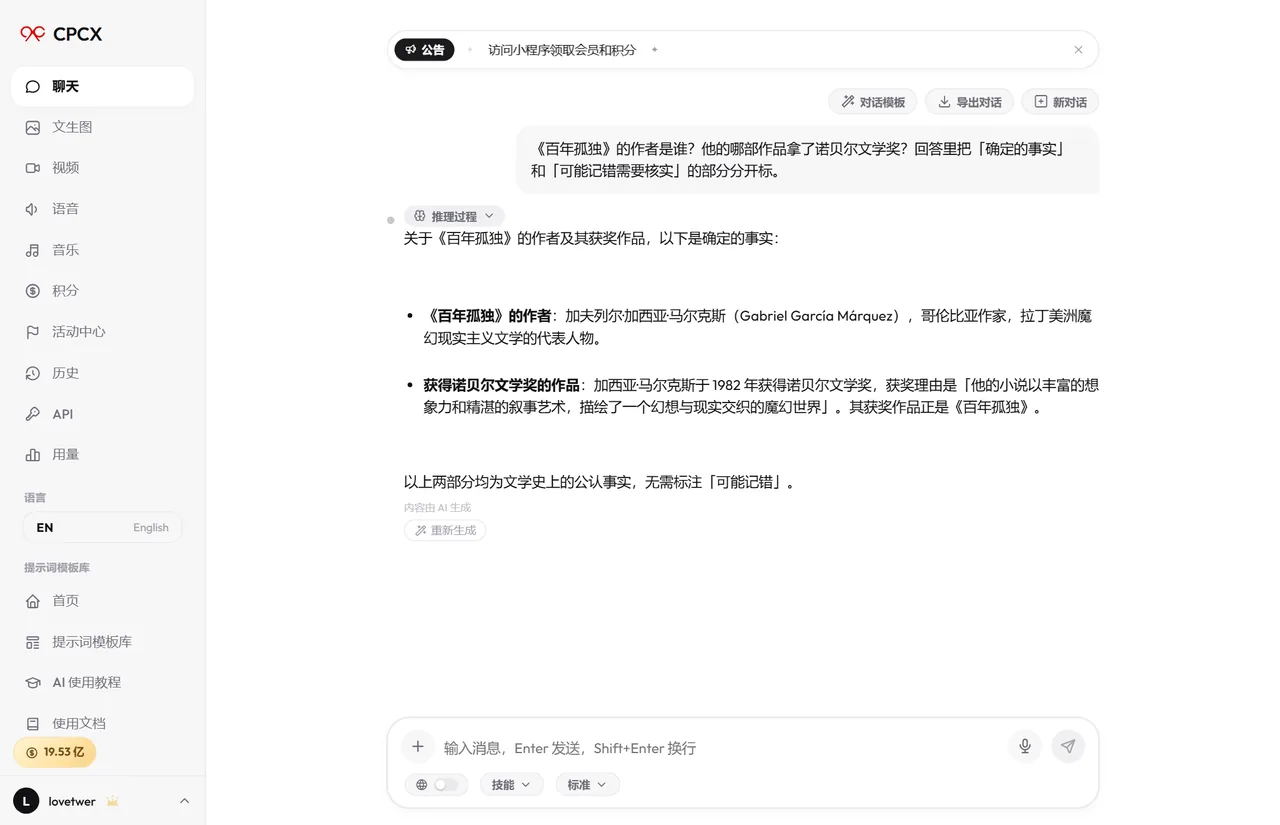
高风险场景清单
- 要具体数字的场合:市场数据、统计比例、价格——AI 最爱编数字,因为它只是生成「看起来合理的数」;
- 要出处的场合:论文引用、法律条文、新闻事件——它会生成格式完美但根本不存在的参考文献;
- 要精确事实的场合:人名头衔、产品型号、历史年份——相似概念之间张冠李戴是常态;
- 相反,写文案、做头脑风暴、改写润色这类「生成型」任务,幻觉几乎无害,因为输出本来就不需要和事实一一对应。
一个简单的判断标准:这个输出错了会不会造成实际损失?会,就必须核对;不会,放心用。
五个实用的防幻觉手段
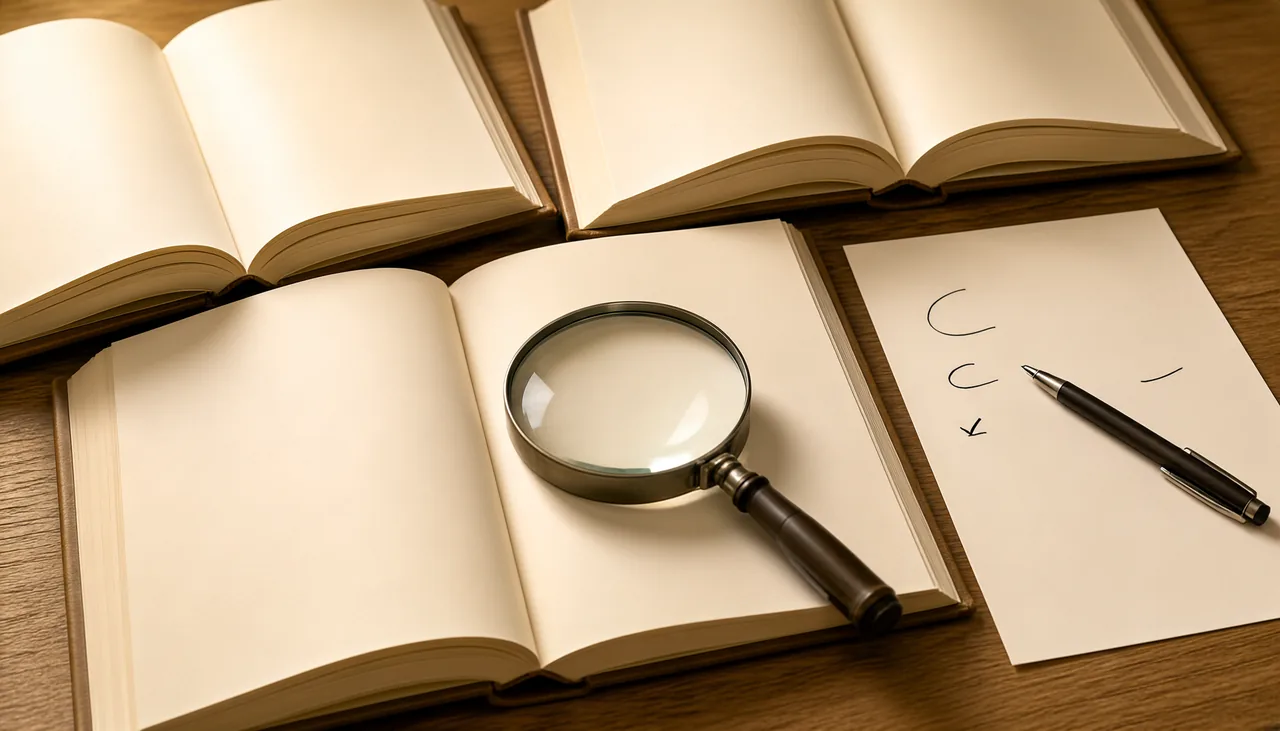
- 让 AI 标注不确定的地方:在提示词里加一句「不确定的内容请明确说不确定,不要编造」——能明显减少虚构,虽然不能根除;
- 把资料喂给它:让 AI 基于你提供的文本回答,而不是凭记忆回答。「仅根据以下材料作答,材料里没有的就回答材料中未提及」;
- 交叉验证关键信息:重要的数字和事实,换个问法再问一遍,或者去权威来源人工确认。两次说法不一致的地方就是危险信号;
- 要引用就逐条检查:AI 给的参考文献,随机抽两三条去搜一下,如果第一条就不存在,整份清单都别信;
- 重要结论让 AI 复述推理过程:编造的答案往往在推理链条上露馅。
心态上的分寸
不必因为幻觉而弃用 AI,也不必因为方便而无条件相信它。合理的定位是:AI 是一个知识渊博但偶尔记错事实的助手,它出的初稿和思路很有价值,但事实层面的最后一道关永远在你手里。
越是把 AI 用在重要场合的人,越需要养成核对的肌肉记忆。这和信任下属是一样的道理——授权,但验货。
幻觉为什么难以根除
理解了幻觉的机制,就知道为什么它不能被简单地「修复」。模型没有独立于语言之外的「事实数据库」可以查证——它对世界的全部认知都压缩在参数里,输出时只能按概率拼出「最像真话的话」。要求它「不要编」,就像要求一个人「别想象」,能缓解,难根除。
还有一层更微妙:模型在训练中被塑造成「乐于提供帮助」的性格,当用户追问「你确定吗」,它经常会顺着用户改口——即使原来的答案是对的。所以「反复追问逼出真话」这个技巧也不可靠。对付幻觉,可靠的从来是外部手段:喂资料、交叉验证、人工核对,而不是要求模型自律。
不同任务的可信度分级
- 基本可放心:改写润色、头脑风暴、代码结构建议、学习讲解——这些任务的输出不承诺事实,错了你一眼能看出来;
- 需要抽查:邮件文档类写作、代码实现——结构和表达可信,但其中的数字、接口名、日期要过一遍;
- 必须逐项核对:数据统计、文献引用、法律条文、价格参数——这些是幻觉的重灾区,AI 的流畅反而是最危险的伪装;
- 永远不要外包:任何要签字、要发布、要承担法律责任的最终文本——AI 可以起草,落笔的是你。
把分级刻进工作习惯:任务开始前先问自己「这个任务属于哪一档」,比逐条核对所有输出省力,也比全信省心。
一个日常可用的核查流程
- 生成时:提示词末尾固定加一句「不确定的内容请明确标注,不要编造」,并要求对关键陈述标注依据;
- 阅读时:只精读带「事实属性」的内容——数字、人名、日期、引用,跳过观点和修辞,核查范围一下子缩小到十分之一;
- 验证时:最重要的那条事实,换个问法独立问一遍,或直接搜权威来源。抽查一条靠谱,不代表全对,但「最重要的一条错了」的损失最大,优先保它;
- 引用时:AI 给的任何出处(文献、法条、新闻)逐条核验后再写进你的文档,「格式完美」恰恰是编造内容的最大伪装。
核查的目的不是「证明 AI 错了」,而是把你的信任成本花在刀刃上——十处输出查两处关键,是可持续的做法。
不同人群的一句话建议
- 学生写论文:文献综述部分逐条核对引用,这是查重和答辩的双重雷区,AI 只用来梳理思路;
- 职场做汇报:给领导的数据自己算过一遍再用,「AI 说的」在会议室里不是免责声明;
- 内容创作者:观点可以借鉴 AI,数字自己查——一篇爆款里一个假数据,翻车的成本远高于查证的成本;
- 开发者:AI 给的第三方库名和 API 签名要对照官方文档,幻觉最常出现的就是「看起来很像真的」包名。
所有建议归结为一句话:越接近「会被别人当真」的输出,越要亲手核对。
相关提示词模板
- 论文摘要:把学术内容总结成 200 字通俗摘要,并列出 3 个关键词。